Como abrir arquivos .DBC do DATASUS e converter para CSV/Parquet
Publicado: Atualizado: Por: Komesu, D.K.
 Ilustração: Quantilica Editorial
Guia prático para abrir arquivos .dbc do DATASUS (SIM, SINASC, SIH, SIA, SINAN) sem TabWin: conversão no navegador, pela CLI Quantilica e em Python (datasus-fetcher 0.14.0 ou superior), com exemplo real de um arquivo do SIM e comparação de tamanho entre DBC, DBF, CSV e Parquet.
Um arquivo .dbc do DATASUS é uma tabela DBF (o formato do dBase) comprimida com o algoritmo PKWARE DCL Implode. Por isso o Excel, o LibreOffice e o pandas não o abrem: antes de qualquer análise, o arquivo precisa ser descomprimido para .dbf e, de preferência, convertido para um formato moderno, como CSV (para planilhas) ou Parquet (para análise em Python, R ou SQL).
Há três caminhos que dispensam o TabWin: o conversor do Quantilica no navegador, que gera CSV sem instalar nada; a linha de comando quantilica datasus, que converte arquivos ou pastas inteiras para Parquet; e a biblioteca Python datasus-fetcher, que lê o .dbc direto para um DataFrame. Os três foram testados neste guia com um arquivo real do Sistema de Informações sobre Mortalidade (SIM): as declarações de óbito do Acre em 2022.
Versão mínima:
datasus-fetcher0.14.0. Versões anteriores podiam ler colunas deslocadas em arquivos do DATASUS. Se você gerou Parquets ou CSVs com uma versão mais antiga, refaça a conversão (detalhes na seção Quem converteu com versões anteriores).
O que é um arquivo .dbc do DATASUS
O .dbc é um formato próprio do DATASUS: um cabeçalho DBF seguido dos registros comprimidos pelo algoritmo implode da PKWARE Data Compression Library, o mesmo usado em versões antigas do PKZIP. O DATASUS o adotou nos anos 1990 para reduzir o volume dos microdados distribuídos por FTP e lidos pelo TabWin. A compressão é eficiente (o arquivo deste guia fica 6,2 vezes maior depois de descomprimido), mas nenhuma ferramenta de uso geral a reconhece.
Os detalhes do algoritmo, e por que ler o arquivo bruto é condição de reprodutibilidade, estão em Reprodutibilidade no SUS: como extrair e validar microdados em Python. Aqui o foco é prático: sair do .dbc e chegar a um arquivo que você consiga abrir.
Antes de converter: baixe o arquivo certo
Os microdados ficam no FTP público ftp.datasus.gov.br, sob /dissemin/publicos/. Cada sistema tem uma pasta e uma convenção de nome que combina prefixo do sistema, UF e período:
| Sistema | Pasta no FTP | Exemplo de arquivo | Tamanho do .dbc |
|---|---|---|---|
| SIM (óbitos) | SIM/CID10/DORES/ |
DOAC2022.dbc (Acre, 2022) |
330.408 bytes |
| SINASC (nascidos vivos) | SINASC/1996_/Dados/DNRES/ |
DNAC2022.dbc (Acre, 2022) |
681.675 bytes |
| SIH-RD (internações) | SIHSUS/200801_/Dados/ |
RDAC2408.dbc (Acre, ago/2024) |
346.250 bytes |
| SIA-PA (produção ambulatorial) | SIASUS/200801_/Dados/ |
PAAC2607.dbc (Acre, jul/2026) |
3.976.061 bytes |
| SINAN (dengue) | SINAN/DADOS/FINAIS/ |
DENGBR21.dbc (Brasil, 2021) |
23.488.890 bytes |
| CNES-LT (leitos) | CNES/200508_/Dados/LT/ |
LTAC2609.dbc (Acre, set/2026) |
3.621 bytes |
Se ainda não sabe qual sistema responde à sua pergunta, comece por DATASUS: SIM, SINASC, SIH, SIA ou SINAN? Qual base usar. Para baixar muitos arquivos com interface gráfica, veja Como baixar arquivos do DATASUS com o FileZilla.
Uma armadilha frequente: a extensão varia entre maiúsculas e minúsculas no mesmo diretório. Na pasta do SIM, o Acre tem DOAC2007.DBC, DOAC2010.DBC e DOAC2012.DBC ao lado de DOAC2022.dbc. O servidor aceita as duas grafias no download, mas um script em Linux ou macOS que procure só *.dbc deixa os arquivos .DBC de fora sem avisar.
Em Python, a biblioteca padrão basta para baixar um arquivo:
import urllib.request
from pathlib import Path

URL = "ftp://ftp.datasus.gov.br/dissemin/publicos/SIM/CID10/DORES/DOAC2022.dbc"

dbc = Path("DOAC2022.dbc")
if not dbc.exists():
    urllib.request.urlretrieve(URL, dbc)
print(dbc.name, dbc.stat().st_size, "bytes")
Saída: DOAC2022.dbc 330408 bytes.
Caminho 1: converter no navegador, sem instalar nada
O conversor DBC do Alpaca descomprime o arquivo e gera CSV ou DBF dentro do próprio navegador [1]. Basta arrastar o .dbc para a página e clicar em Baixar CSV ou Baixar DBF.
Com o DOAC2022.dbc, o conversor produziu 4.159 registros e o primeiro óbito com DTOBITO = 07052022, CAUSABAS = I461 e CODMUNRES = 120017, os mesmos valores que os caminhos 2 e 3 devolvem. O CSV sai em UTF-8 com BOM, separado por vírgula e com os espaços de preenchimento removidos (1,07 MB neste exemplo).
Dois cuidados. No Excel em português, o separador padrão de listas é o ponto e vírgula; abra o arquivo por Dados > De Texto/CSV, que detecta a vírgula, em vez de dar duplo clique. E o conversor carrega o arquivo inteiro na memória do navegador: serve bem para arquivos de uma UF e um período, não para o SIA-PA de São Paulo.
Caminho 2: linha de comando com a CLI Quantilica
A CLI quantilica instala o datasus-fetcher sob demanda a partir do índice de pacotes do projeto (index.quantilica.com). O extra analysis traz Polars, PyArrow e os leitores de DBF, necessários para o comando convert:
python -m venv .venv
source .venv/bin/activate          # no Windows: .venv\Scripts\activate
pip install quantilica-cli
quantilica install datasus --extra analysis
Em um ambiente limpo, esse procedimento instala o datasus-fetcher 0.14.0. Se você já tinha o pacote instalado, atualize explicitamente; a versão publicada no PyPI está desatualizada, por isso o índice do Quantilica precisa estar na linha de comando:
pip install -U "datasus-fetcher[analysis]>=0.14.0" --extra-index-url https://index.quantilica.com/simple/
Com o pacote instalado, a descompressão pura (DBC para DBF) e a conversão para Parquet são dois comandos:
# DBC -> DBF (aceita um arquivo ou uma pasta)
quantilica datasus decompress -i DOAC2022.dbc -o DOAC2022.dbf

# DBC (ou DBF) -> Parquet, arquivo a arquivo ou pasta inteira
quantilica datasus convert -i DOAC2022.dbc -o DOAC2022.parquet
quantilica datasus convert -i pasta_com_dbc/ -o parquet/ --format parquet --workers 4
O convert aplica por padrão a limpeza canônica (--clean), deixa os nomes de coluna em minúsculas (--lowercase) e acrescenta as colunas uf e ano, extraídas do nome do arquivo. Use --no-clean --no-lowercase para manter os campos exatamente como vêm do DATASUS e --compression snappy se o seu leitor não suportar zstd. Numa pasta com DOAC2010.DBC e DOAC2022.dbc, o comando converteu os dois, com extensão maiúscula ou minúscula.
O convert não gera CSV. Para CSV, use o caminho 1 ou o 3.
Caminho 3: Python, do DBC ao DataFrame, CSV e Parquet
Comece conferindo a versão instalada:
from importlib.metadata import version

versao = version("datasus-fetcher")
print("datasus-fetcher", versao)
major, minor = (int(x) for x in versao.split(".")[:2])
assert (major, minor) >= (0, 14), "Atualize o datasus-fetcher para 0.14.0 ou superior"
O fluxo completo cabe em poucas linhas. decompress_dbc grava o .dbf ao lado do original (útil se você quer guardar o DBF); read_dbc descomprime num arquivo temporário e devolve um DataFrame Polars. Com clean=False, lowercase=False, a leitura é crua: nomes originais, todos os campos como texto e a coluna técnica _deleted, que marca registros apagados no DBF e pode ser descartada.
import urllib.request
from pathlib import Path

from datasus_fetcher import decompress_dbc, read_dbc

URL = "ftp://ftp.datasus.gov.br/dissemin/publicos/SIM/CID10/DORES/DOAC2022.dbc"
dbc = Path("DOAC2022.dbc")
if not dbc.exists():
    urllib.request.urlretrieve(URL, dbc)

# 1. DBC -> DBF (opcional: o read_dbc faz isso sozinho num arquivo temporário)
dbf = decompress_dbc(dbc)

# 2. DBC -> DataFrame Polars, sem limpeza: nomes originais e tudo como texto
df = read_dbc(dbc, clean=False, lowercase=False).drop("_deleted")
print(df.shape)
print(df.select("DTOBITO", "CAUSABAS", "CODMUNRES", "SEXO", "IDADE").head(3))

# 3. DataFrame -> CSV e Parquet
df.write_csv("DOAC2022.csv")
df.write_parquet("DOAC2022.parquet", compression="zstd")

for arquivo in (dbc, dbf, Path("DOAC2022.csv"), Path("DOAC2022.parquet")):
    print(f"{arquivo.name:<18}{arquivo.stat().st_size:>12,} bytes")
Saída (com Polars 1.41; o tamanho do Parquet varia alguns bytes entre versões do Polars):
(4159, 87)
┌──────────┬──────────┬───────────┬──────┬───────┐
│ DTOBITO  ┆ CAUSABAS ┆ CODMUNRES ┆ SEXO ┆ IDADE │
╞══════════╪══════════╪═══════════╪══════╪═══════╡
│ 07052022 ┆ I461     ┆ 120017    ┆ 1    ┆ 446   │
│ 14052022 ┆ I10      ┆ 120017    ┆ 2    ┆ 463   │
│ 28052022 ┆ Q201     ┆ 120050    ┆ 2    ┆ 401   │
└──────────┴──────────┴───────────┴──────┴───────┘
DOAC2022.dbc          330,408 bytes
DOAC2022.dbf        2,040,728 bytes
DOAC2022.csv        1,444,770 bytes
DOAC2022.parquet      203,105 bytes
Para análise, prefira a leitura com limpeza, informando o identificador do conjunto de dados (sim-do-cid10, sinasc-dn, sih-rd, sia-pa, sinan-deng, cnes-lt). O wrangle_datasus, aplicado internamente, remove _deleted, padroniza os nomes em minúsculas e converte os campos numéricos conhecidos de cada sistema (valores e diárias do SIH, por exemplo); códigos como SEXO e RACACOR continuam texto, para não perder zeros à esquerda. A função também pode ser chamada sobre um DataFrame lido com clean=False. O trecho abaixo faz ainda uma conferência simples: toda causa básica deve ter formato de código CID-10.
import urllib.request
from pathlib import Path

from datasus_fetcher import read_dbc

URL = "ftp://ftp.datasus.gov.br/dissemin/publicos/SIM/CID10/DORES/DOAC2022.dbc"
dbc = Path("DOAC2022.dbc")
if not dbc.exists():
    urllib.request.urlretrieve(URL, dbc)

df = read_dbc(dbc, dataset="sim-do-cid10")  # limpeza canônica + colunas minúsculas

# Conferência: toda causa básica deve ter formato CID-10 (letra + 2 ou 3 dígitos)
cid_ok = df["causabas"].str.contains(r"^[A-Z][0-9]{2,3}$").sum()
print(f"{cid_ok} de {df.height} causas básicas no formato CID-10")
print("1º registro:", df.row(0, named=True)["causabas"])

capitulos = df["causabas"].str.slice(0, 1).value_counts(sort=True)
print(capitulos.head(5))
Saída: 4159 de 4159 causas básicas no formato CID-10, primeiro registro I461, e os cinco capítulos mais frequentes: I (doenças do aparelho circulatório, 910 óbitos), J (respiratório, 629), C (neoplasias, 567), R (causas mal definidas, 323) e X (causas externas do grupo X, 302).
Se o destino for o Excel em português, grave com ponto e vírgula e BOM, e o duplo clique passa a abrir as colunas certas:
import urllib.request
from pathlib import Path

from datasus_fetcher import read_dbc

URL = "ftp://ftp.datasus.gov.br/dissemin/publicos/SIM/CID10/DORES/DOAC2022.dbc"
dbc = Path("DOAC2022.dbc")
if not dbc.exists():
    urllib.request.urlretrieve(URL, dbc)

df = read_dbc(dbc, clean=False, lowercase=False).drop("_deleted")

# CSV para abrir com duplo clique no Excel em português: ponto e vírgula e BOM UTF-8
df.write_csv("DOAC2022_excel.csv", separator=";", include_bom=True)
print(Path("DOAC2022_excel.csv").read_bytes()[:40])
Quem converteu com versões anteriores
O DATASUS grava zerado, no cabeçalho de cada .dbf, o campo que indica a posição de cada coluna dentro do registro. O leitor rápido usado pelo datasus-fetcher (fastdbf) confiava nesse campo e, nas versões anteriores à 0.14.0, lia vários campos a partir do início do registro. O resultado eram colunas deslocadas: no DOAC2022.dbc, CAUSABAS vinha como " 120" em vez de I461, e DTOBITO como " 1207052" em vez de 07052022.
A versão 0.14.0 recalcula as posições a partir dos tamanhos dos campos antes da leitura e compara as primeiras 50 linhas de cada bloco lido com o dbfread, um leitor independente; se houver divergência, o bloco é relido pelo dbfread e um aviso é registrado no log. O arquivo de origem não é alterado.
Na prática:
- Parquets, CSVs e DataFrames gerados com
read_dbc,read_dbfouquantilica datasus convertem versões anteriores à 0.14.0 devem ser refeitos a partir dos.dbcoriginais. - Os
.dbfgerados pordecompress_dbcouquantilica datasus decompressnão foram afetados: a descompressão estava correta, o problema era só a leitura. - O conversor do navegador (caminho 1) calcula as posições pelos tamanhos dos campos e não teve esse problema.
- Uma verificação rápida é a do bloco anterior: em arquivos do SIM,
causabasfora do padrão de código CID-10 indica leitura incorreta.
Quanto ocupa cada formato
O mesmo arquivo, medido em disco depois de cada etapa:
| Formato | Tamanho | Relação com o .dbc | Para que serve |
|---|---|---|---|
.dbc (FTP) |
330.408 bytes | 1,0× | Distribuição; nada abre direto |
.dbf |
2.040.728 bytes | 6,2× | Compatibilidade com R, Stata, TabWin |
.csv |
1.444.770 bytes | 4,4× | Excel, LibreOffice, qualquer linguagem |
.parquet (zstd) |
cerca de 203.000 bytes | 0,6× | Análise em Python, R, DuckDB, Spark |
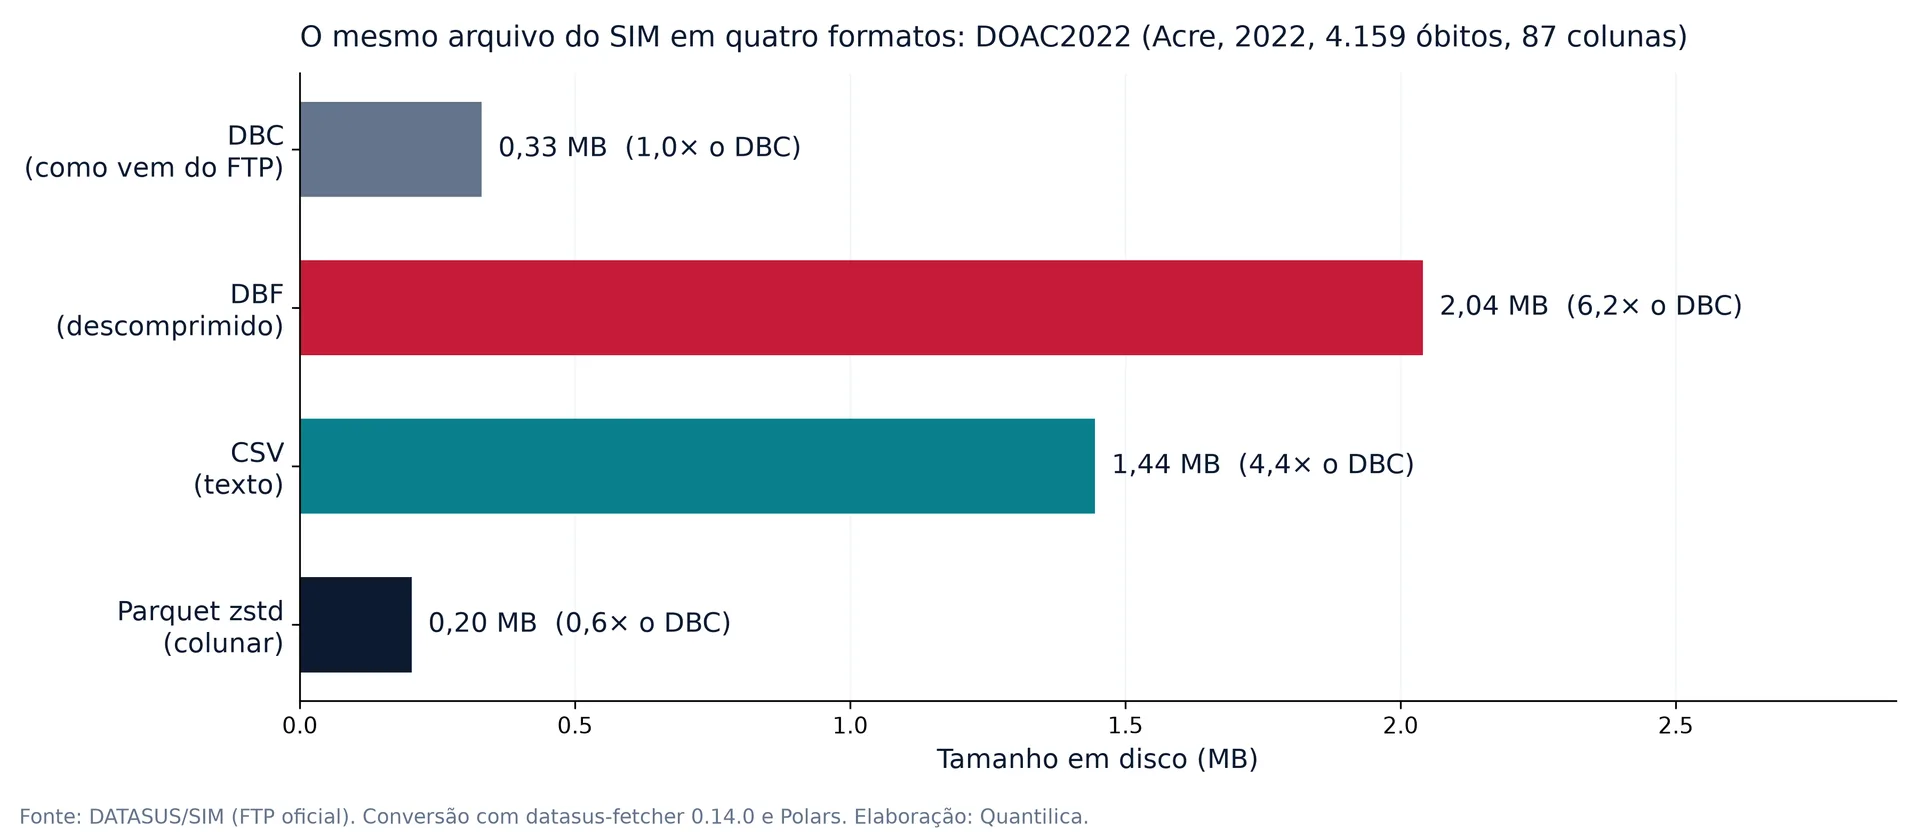
O Parquet fica menor que o próprio .dbc porque é colunar: valores repetidos de uma mesma coluna (UF, sexo, códigos de município) comprimem muito melhor juntos do que registro a registro. Além disso, guarda os tipos de dados e permite ler só as colunas necessárias. A recomendação é guardar o .dbc original como fonte, trabalhar em Parquet e gerar CSV apenas quando alguém precisar abrir no Excel.
O fator de expansão varia por sistema: o PAAC2607.dbc do SIA-PA (Acre, julho de 2026) tem 3.976.061 bytes e vira um .dbf de 58.776.824 bytes, quase 15 vezes maior.
Problemas comuns
- Acentuação quebrada. Os DBF do DATASUS usam Latin-1 (ISO-8859-1). O
read_dbce oread_dbfjá usamencoding="latin1"por padrão; se ler o.dbfcom outra ferramenta, informe essa codificação. - Zeros à esquerda sumindo. Códigos de município, CNES, CID e ocupação devem ser lidos como texto. Abrir o CSV com duplo clique no Excel converte
0101em101; importe a coluna como texto. - Datas como texto. No SIM,
DTOBITOvem no formatoDDMMAAAA(07052022). Converta explicitamente, por exemplo compl.col("dtobito").str.to_date("%d%m%Y")no Polars. - Idade codificada. No SIM,
IDADEtem três dígitos e o primeiro indica a unidade:446significa 46 anos (unidade 4, anos). Consulte o dicionário do sistema antes de tratar o campo como número. - Layout que muda entre anos. O
DOAC2010tem 60 colunas e oDOAC2022, 87. Ao empilhar anos, use concatenação que tolere colunas diferentes (pl.concat(..., how="diagonal_relaxed")). - Arquivos grandes. O
read_dbflê arquivos grandes em blocos (chunk_bytes) para limitar o uso de memória; mesmo assim, converta arquivo a arquivo e grave em Parquet antes de juntar UFs e meses. - Extensão
.DBCmaiúscula. Ao listar arquivos em Python, use um padrão que ignore a caixa, como[p for p in pasta.iterdir() if p.suffix.lower() == ".dbc"].
Se, depois de converter, você quiser cruzar os microdados com séries econômicas (população, inflação, gasto público), veja o guia API gratuita de dados econômicos do Brasil em Python.
Perguntas Frequentes
Como abrir um arquivo .dbc do DATASUS no Excel?
O Excel não abre .dbc diretamente, porque o arquivo é um DBF comprimido. Converta-o antes para CSV, no conversor do navegador ou em Python com read_dbc e write_csv, e abra o CSV pelo menu Dados > De Texto/CSV.
Como converter DBC para CSV sem instalar o TabWin?
Pelo conversor do Alpaca no navegador, que não exige instalação e não envia o arquivo a nenhum servidor, ou em Python com o datasus-fetcher 0.14.0 ou superior: read_dbc(arquivo, clean=False).write_csv("saida.csv"). A CLI quantilica datasus convert gera Parquet e DBF, não CSV.
Como ler arquivos .dbc em Python?
Instale o datasus-fetcher com o extra analysis (quantilica install datasus --extra analysis) e use from datasus_fetcher import read_dbc. A função devolve um DataFrame Polars; para pandas, chame .to_pandas() no resultado.
Qual a diferença entre .dbc e .dbf?
O .dbf é a tabela no formato dBase, legível por R, Stata, LibreOffice e bibliotecas Python. O .dbc é o mesmo conteúdo comprimido pelo algoritmo PKWARE DCL Implode, formato que só o DATASUS usa; no exemplo deste guia, o DBF é 6,2 vezes maior que o DBC.
Parquet ou CSV: qual formato usar para microdados do SUS?
Parquet para análise: no exemplo, ocupou cerca de 203 KB contra 1,44 MB do CSV, preserva tipos e permite ler só as colunas necessárias. CSV quando o arquivo precisa ser aberto em planilha ou enviado a alguém sem ferramentas de dados.
Converti arquivos antes da versão 0.14.0 do datasus-fetcher. Preciso refazer?
Sim, se a conversão usou read_dbc, read_dbf ou quantilica datasus convert: essas leituras podiam deslocar colunas. Atualize para a 0.14.0 ou superior e converta de novo a partir dos .dbc; os .dbf gerados só por descompressão continuam válidos.
Referências técnicas
- BRASIL. Ministério da Saúde. DATASUS. Transferência de arquivos. Brasília. Disponível em: https://datasus.saude.gov.br/transferencia-de-arquivos/.
- BRASIL. Ministério da Saúde. DATASUS. Informações de Saúde (TABNET). Brasília. Disponível em: https://datasus.saude.gov.br/informacoes-de-saude-tabnet/.
- BRASIL. Ministério da Saúde. DATASUS. CID-10: Classificação Estatística Internacional de Doenças e Problemas Relacionados à Saúde. Disponível em: http://www2.datasus.gov.br/cid10/V2008/cid10.htm.
- DBASE LLC. Xbase file format description (dBASE 7 table file format). Disponível em: https://www.dbase.com/Knowledgebase/INT/db7_file_fmt.htm.
- APACHE SOFTWARE FOUNDATION. Apache Parquet documentation. Disponível em: https://parquet.apache.org/docs/.
- POLARS. DataFrame.write_csv / DataFrame.write_parquet: API reference. Disponível em: https://docs.pola.rs/api/python/stable/reference/api/polars.DataFrame.write_csv.html.
- QUANTILICA. Índice de pacotes Python do ecossistema Quantilica. Disponível em: https://index.quantilica.com/simple/.
Leia também: DATASUS: qual base usar · Reprodutibilidade no SUS em Python · Baixar arquivos do DATASUS com o FileZilla · API gratuita de dados econômicos em Python